AI 模型的能力包山包海,從一開始的簡單問答,到現在組成 AI 團隊獨立完成一個系統程式,甚至還能破解人類未解的數學難題,生成圖片影片也難不倒它。但剛開始使用很快會遇到幾個問題:同一家公司同時有三四款最新的模型,名稱各不相同;對話越長,額度消耗越快,回答也可能變差,上下文是什麼?設定裡還有 effort 要選。本文以常見的 Claude、GPT、Gemini 為例,從模型、harness 與 Agent 的差別開始,把上下文、模型等級與 effort 一起整理。
AI 模型、harness 與 Agent 是什麼
首先要知道 AI 模型、harness 與 Agent 是什麼,先用一個簡單的譬喻,可以把模型想成大腦,負責看資料、思考、決定下一步,但沒有手腳,不會自己動手;harness 是手腳,負責找到文件、打開來讀、改寫內容、操作其他軟體,也會限制大腦能做哪些事。兩者合起來的 Agent,就是一個完整的機器人助手。Agent 的大腦與手腳都可以替換:同一個 harness 可以切換不同模型,例如 OpenCode 能接各家公司的模型;同一個模型也可以放進不同的 harness。
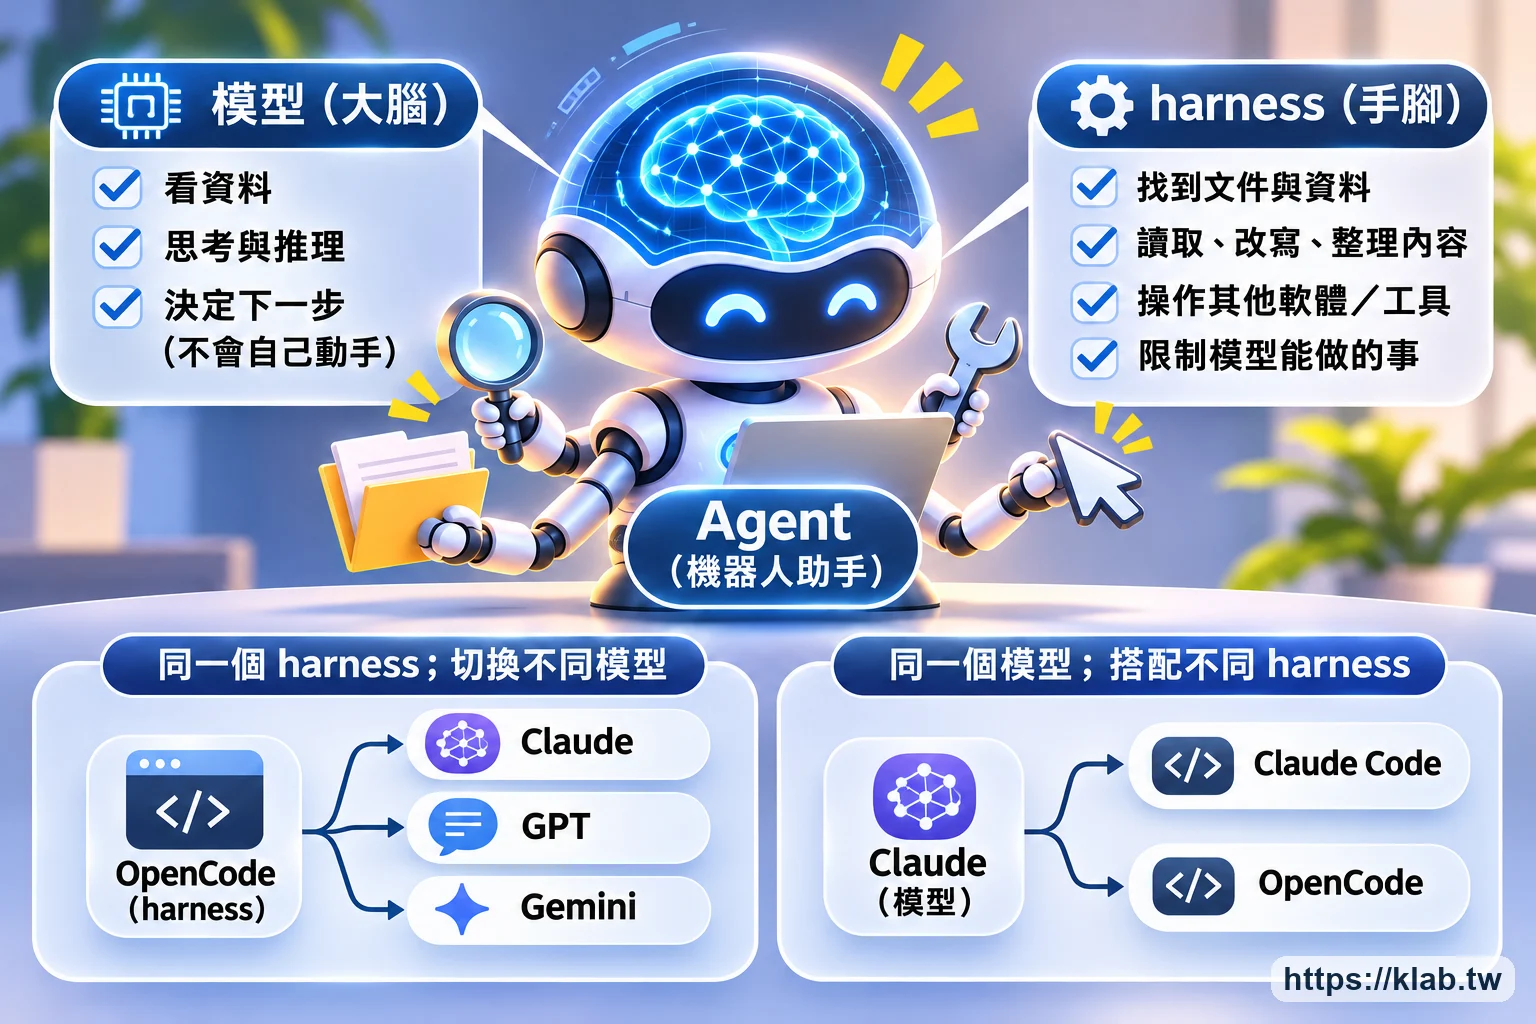
AI 模型通常指大語言模型(LLM, Large Language Model),用大量文字與資料訓練而成:輸入一段內容,模型依訓練時學到的規律,預測出最合適的回應。Claude 由 Anthropic 開發,GPT 由 OpenAI 開發,Gemini 由 Google 開發。模型本身只負責接收內容、產生回應,不會自己開檔案、上網或執行程式。
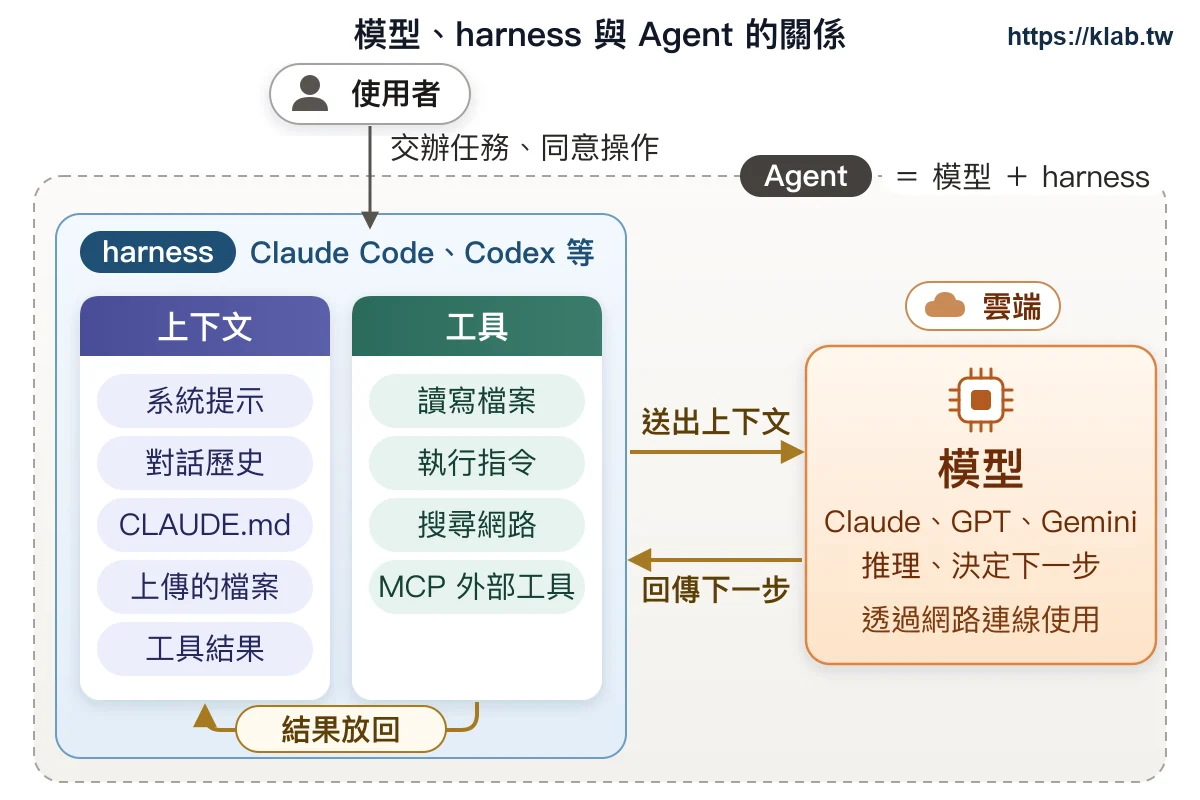
harness 是包在模型外面的那層軟體,負責提供工具、決定模型這一輪看得到哪些內容,再把模型要求的動作實際執行出來。 Claude Code 官方文件 的說法是:模型負責推理,工具負責動作,Anthropic 的 Claude Code 就是包在模型外面、提供工具並管理上下文的那一層,這一層稱為 agentic harness。OpenAI 也把自家的 Codex 稱為 harness。 OpenCode 是開源的同類工具,有終端機、桌面 App 與 IDE 擴充三種形式,設定 API 金鑰就能接上不同公司的模型。
Agent 是模型加上 harness 之後,能根據執行結果自己決定下一步、反覆使用工具直到完成工作的系統。 Anthropic 把 agent 描述成模型在迴圈裡依環境回饋使用工具; OpenAI 的 Agent 指南 則把只回答單輪問題的聊天機器人排除在 agent 之外。在 ChatGPT 裡一問一答是聊天;讓 Claude Code 讀專案、改程式、跑測試,直到測試通過,就是 Agent 在工作。
| 名稱 | 負責什麼 | 例子 |
|---|---|---|
| 模型 | 理解內容,決定要回答什麼、要用哪個工具 | Claude Opus 5.5、GPT-6.1 Sol、Gemini 3.8 Flash |
| harness | 提供工具、管理上下文、執行模型要求的動作,需要時停下來請使用者同意 | Claude Code、Codex、OpenCode |
| Agent | 模型與 harness 反覆執行,直到完成多步驟工作 | 用 Claude Code 修 bug、用 Codex 改程式並跑測試 |
同一個模型換 harness,結果可能差很多
Agent 的表現不只看模型。 Anthropic 說明 SWE-bench(用真實 GitHub 問題測試修 bug 能力的評測)成績時提到,即使底層是同一個模型,外層軟體不同,成績也可能有明顯差距。 OpenAI 也舉過例子:同一個模型只調整 harness,保留推理內容,並把較早的對話整理成摘要,在 ARC-AGI-3 推理評測的分數就從 13.3% 提高到 38.3%。比較 Claude Code、Codex 這類工具時,比的是模型與 harness 的組合。
harness 的設計方式,以及提示詞與上下文怎麼安排,在 Harness Engineering 有更完整的介紹。
上下文是什麼
上下文(context)是模型這一次產生回答時能參考的全部內容;上下文視窗(context window)是這些內容的長度上限。 Anthropic 文件 把上下文視窗比喻成模型的「工作記憶」:模型只看得到放在裡面的東西,視窗以外的內容,模型在這一輪完全看不到。如果開啟兩個對話視窗,就會有兩份獨立的上下文,就像兩個各自擁有工作記憶的助手。
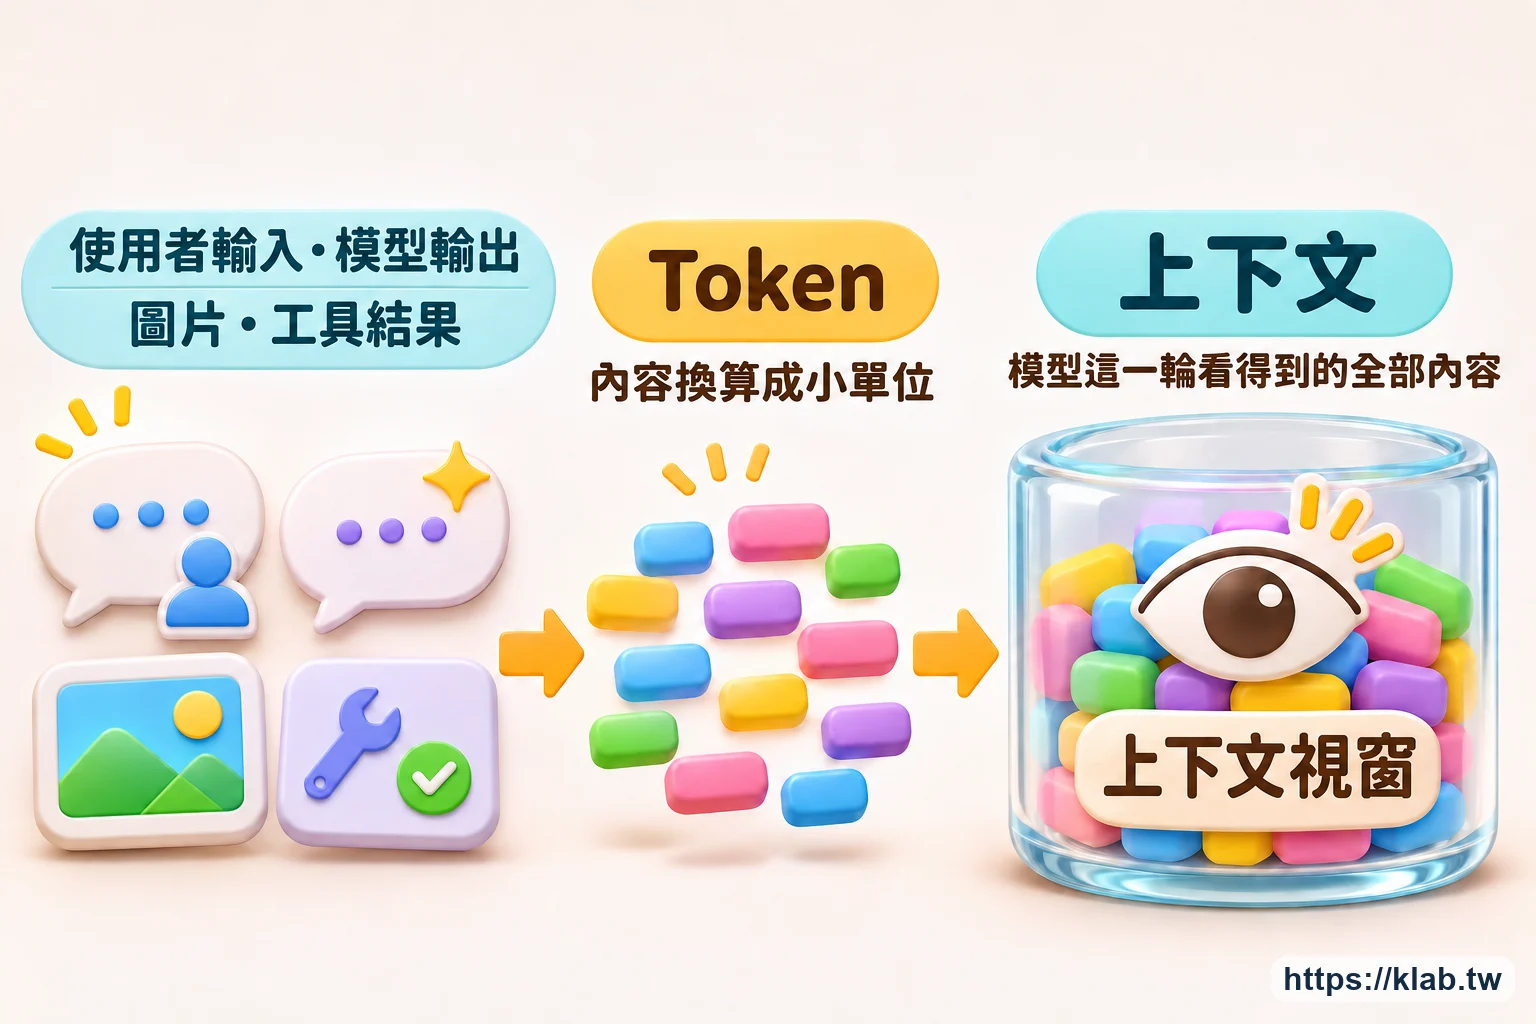
上下文不只有使用者輸入的文字,一次請求通常包含:
- 系統提示:harness 寫給模型的工作規則與身分設定
- 對話歷史:之前每一輪的問題與回答
- 檔案與工具結果:上傳的 PDF 與圖片,Agent 讀過的程式碼、指令輸出、搜尋結果
- 工具說明:harness 內建工具與 MCP 工具的說明,告訴模型有哪些工具可以用
- Skills 摘要:每個 Skill 的名稱與描述
- 專案規則與記憶:Claude Code 的 CLAUDE.md、ChatGPT 的記憶功能
- 模型這一輪的思考與回答
其中系統提示、工具說明、Skills 摘要與專案規則,在開始對話前就已經放進上下文,所以只說一聲 hi,上下文也已經用掉不少;在 Claude Code 輸入 /context 可以看到各部分佔用多少。實際能輸入的空間因此比視窗總容量小, ChatGPT 方案頁 也寫明系統指令、工具、個性設定與記憶都會占用上下文視窗。
Token 是什麼
Token 是模型計算長度與費用的單位,可能是一個字、一個字的一部分或一個符號。英文大約每 4 個字元算 1 個 token, OpenAI 與 Google 都用這個方式估算;圖片、音訊與影片也會換算成 token,例如 Gemini 處理影片每秒約 263 tokens。上下文視窗、API 價格與訂閱額度都以 token 計算。
同一段文字在不同模型上的 token 數也不同。 Anthropic 文件 提到,Claude 4.7 起換了新的 tokenizer(切分 token 的規則),同一段文字比前代 Claude 多出約 30% 的 tokens,實際增幅依語言與內容而異,所以同樣是 100 萬 tokens,新版 Claude 能放的文字比舊版少。
各家上下文視窗多大
2026 年 11 月,透過 API 使用時,Claude、GPT、Gemini 現行模型的上下文視窗都在 100 萬 tokens 左右,Grok 4.7 是 50 萬。在 App 裡能用多少要看方案:Claude 付費方案的現行模型是 100 萬;ChatGPT Plus 的 Instant 是 5.4 萬、推理模式是 25.6 萬,Pro 方案是 12.8 萬與 40 萬;Codex 的 GPT-6.1 Sol 預設 50 萬;Gemini 的 Google AI Pro 方案是 100 萬。
同一個模型,在 ChatGPT 裡可用的上下文比 API 小很多。要放進大量文件時,看的是自己方案的數字,而不是模型規格表上的最大值。透過 API 使用 Gemini 4 Argon 時,上下文視窗由輸入、思考與輸出共用,模型想得越久,能放的輸入就越少。
上下文為什麼影響成本
模型不會記得上一輪,每一輪對話都要把前面的內容重新送一次。 Anthropic 文件 寫明 Messages API 是無狀態(stateless)的,每次都要送出完整的對話歷史; Claude Code 的費用說明 也提到,它每次請求都帶上完整對話,Agent 每用一次工具,還會再送一次帶著工具結果的請求。第 20 輪送出的內容,包含前 19 輪的全部問題、回答與工具結果。
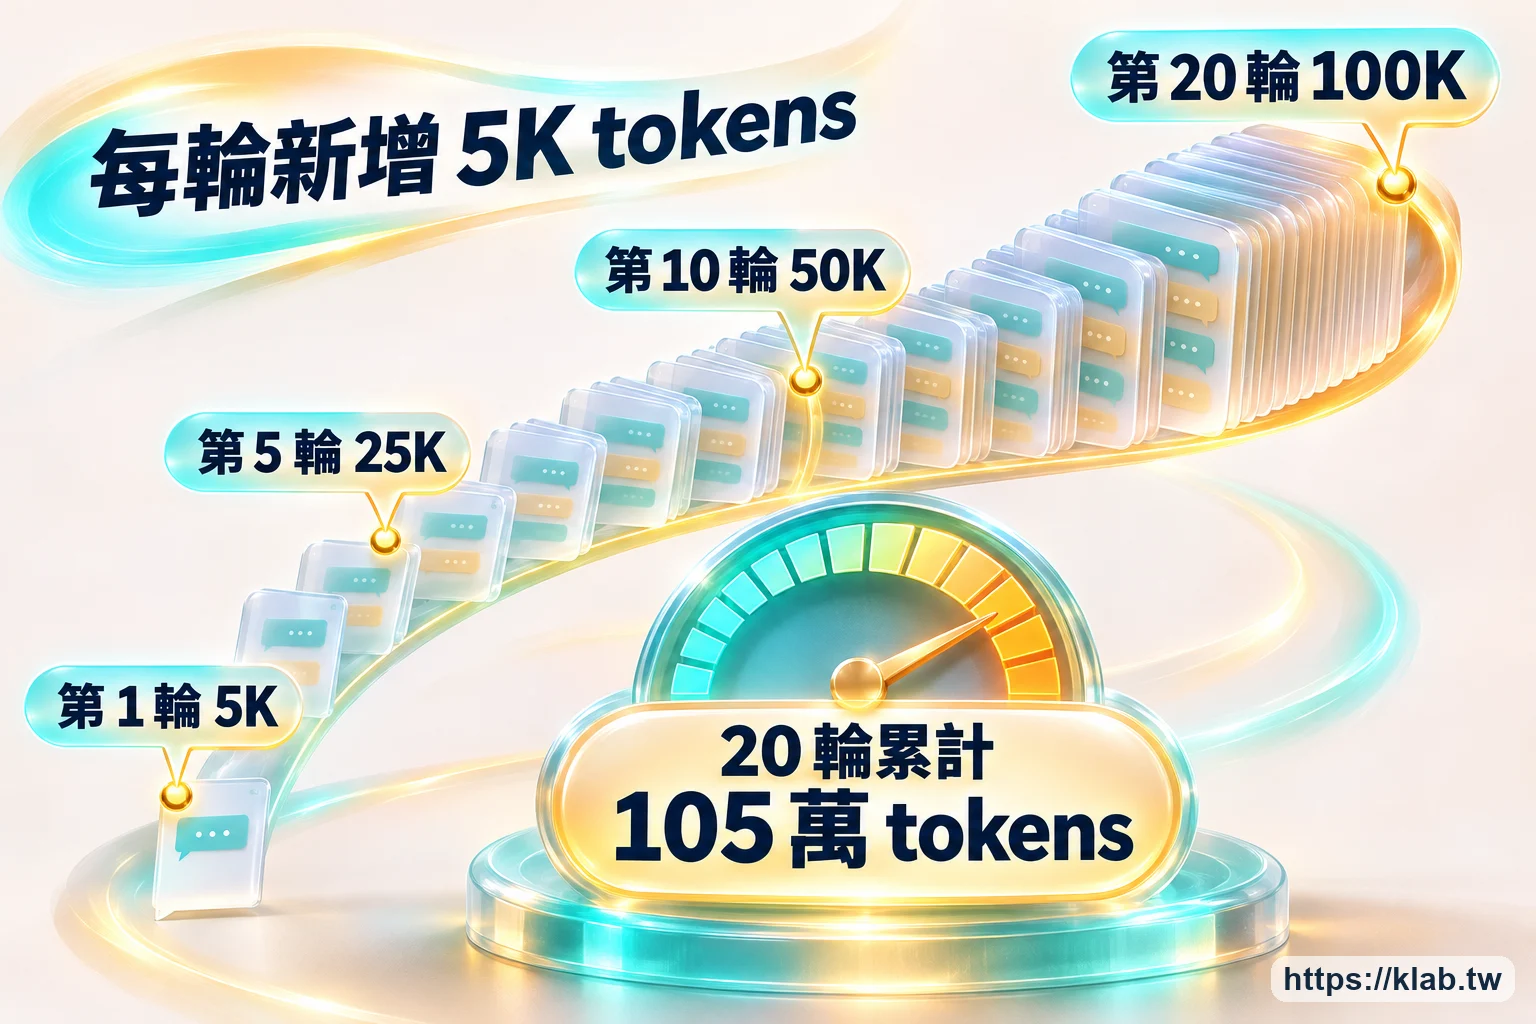
以 API 計價的示意數字計算:假設每一輪新增約 5,000 tokens(問題、回答與工具結果合計),第 20 輪單次就要送出約 10 萬 tokens,20 輪累計送出 105 萬 tokens。以 Claude Sonnet 5.5 每百萬輸入 tokens 2 美元計算,光是輸入就約 2.1 美元,而且輪數越多,每一輪的費用越高。
快取(prompt caching)能省多少
重複送出的前段內容可以用快取(prompt caching)省錢:伺服器記住之前處理過的開頭,下一輪只要這段沒變,就用折扣價計算。快取怎麼運作、哪些操作會讓快取失效,在 Claude Code 節省 Token 與快取指南 有更完整的說明。Claude Code 與 Codex 會自動處理快取,以下的倍率與時效是直接呼叫 API 時要注意的細節。三家的 API 都有快取, OpenAI 與 Gemini 2.5 以後的模型 預設自動啟用。讀取快取的價格是一般輸入價的 1/10 到 1/40:
- Claude:一般為輸入價的 0.1 倍,Opus 5.5 與 Sonnet 5.5 是 0.05 倍,Fable 5.1 是 0.025 倍
- OpenAI:最低為輸入價的 0.05 倍(GPT-6.1 Sol、GPT-6.1 Terra)
- Gemini:以 Gemini 3.8 Flash 為例,快取價是輸入價的 0.1 倍
套回上面的例子,每輪新增的內容寫入快取、前段都讀取快取時,Sonnet 5.5 這 20 輪的輸入費用約 0.35 美元,是不用快取的 1/6 左右。快取有時效, Claude API 預設 5 分鐘,OpenAI 的 GPT-5.6 以後模型預設 30 分鐘、可延長到 12 小時,中間停太久再回來,前段就要用原價重新計算。快取只降低費用,內容照樣占用上下文視窗。Claude Code 與 Codex 的快取差異整理在 Codex 與 Claude Code 快取機制比較。
超過一定長度的請求另外加價
只有直接呼叫 API 才會遇到這項加價:部分模型在輸入超過一定長度後,整筆請求改用較高的單價。
| 模型 | 門檻 | 超過後的單價 |
|---|---|---|
| OpenAI GPT-6 Astra、GPT-6.1 Sol 等 | 輸入超過 272K tokens | 輸入與快取 2 倍,輸出 1.5 倍 |
| Gemini 3.1 Pro Preview | 超過 200K tokens | 輸入 2 倍,輸出 1.5 倍 |
| Grok 4.7 | 200K tokens 以上 | 輸入與輸出都是 2 倍 |
| Claude Haiku 5.5 | 超過 100K tokens | 輸入與輸出都是 5 倍 |
| 其他 Claude 現行模型,Gemini 4 Argon、3.8 Flash | 無 | 整個上下文同一單價 |
訂閱方案的長對話代價
訂閱 ChatGPT 或 Claude 的使用者不按 token 付費,但額度一樣依用量扣除,上面每一輪重送整段對話的機制照樣存在。 OpenAI 說明,GPT-6.1 Sol 從訂閱額度扣除時,在 Codex 與 ChatGPT Work 沒有長上下文加價; Claude 則提到,對話長到觸發自動上下文管理時,會消耗更多用量。長對話在訂閱方案上的代價,是額度用得比較快。
上下文為什麼影響輸出品質
上下文越長,模型越難從中找到並正確使用需要的資訊。 Anthropic 文件 寫著,token 數增加時,準確度與回想能力會下降,這個現象稱為 context rot。 Anthropic 工程部落格 的解釋是,模型處理上下文時有一份「注意力預算」:n 個 token 之間有 n² 組關係要處理,內容越多,每一段分到的注意力越少。
Google 的 長上下文文件 也有類似說明:只找一筆資訊時準確率約 99%,要同時找出多筆資訊時,準確度就會下降;文件也建議在長文件後面才放問題,模型的表現會比較好。 Codex 文件 把問題分成兩種:context rot 是對話塞滿不相關的細節後表現變差,context pollution(上下文污染)是有用的資訊被大量中間輸出淹沒。
自動壓縮會遺漏早期的細節
對話接近上限時,Claude Code 與 Codex 都會自動壓縮(compaction),把前面的對話整理成摘要,騰出空間繼續工作。2026 年 11 月,Claude Code 使用 100 萬 tokens 的模型時,預設在約 96.7 萬 tokens 壓縮。摘要會保留使用者的要求與重要的程式碼片段,但 Claude Code 文件 提到,對話早期的詳細指示可能在摘要中遺失,建議把長期要遵守的規則寫進 CLAUDE.md,壓縮後會重新讀取。 OpenAI 介紹 GPT-6 Astra 時 也提到,每次壓縮都可能遺漏某個修正為何失敗、某個元件如何運作的細節。
讓上下文保持精簡的做法
Claude Code 的最佳實務 提到,多數模型已有 100 萬 tokens 的視窗,壓縮也會自動進行,用完空間的情況不多;換任務時仍建議清空對話,因為聚焦的上下文回答更好、成本也更低。各工具對應的操作:
| 想做的事 | Claude Code | Codex | ChatGPT、Claude、Gemini App |
|---|---|---|---|
| 換一個不相關的工作 | /clear | /new | 開新對話 |
| 指定重點後壓縮 | /compact 加上要保留的重點 | /compact | — |
| 查看上下文用了多少 | /context | /status | — |
/compact 要讀過整段對話才能產生摘要,對很長的上下文執行壓縮,本身就是一次大請求。更多節省 token 的做法整理在 Claude Code 節省 Token 與快取指南。
子 agent(subagent)是另一種隔離上下文的方法: Claude Code 的每個子 agent 有自己的上下文視窗,大量讀檔或搜尋在子 agent 裡完成,只把摘要交回主對話。代價是子 agent 會另外送出請求、多用 token,官方也提到,把同一件工作交給子 agent,答案本身並不會因此變好。
如何保留重要規則
要模型每次都遵守的規則,寫進 harness 會自動讀取的檔案,不要只在對話裡交代。對話內容在清空、開新對話或自動壓縮後就會消失;這些檔案在每次開新對話時重新載入,Claude Code 壓縮對話後也會重新讀取專案的 CLAUDE.md。
常見的有三種。 CLAUDE.md 是 Claude Code 讀取的規則檔; AGENTS.md 是 Codex 與 OpenCode 讀取的規則檔,Claude Code 在專案沒有 CLAUDE.md 時也會改讀它。Skills 則是一個資料夾放一項技能,主檔是 SKILL.md;平常只有名稱與描述放在上下文裡,需要時才載入完整內容,比規則檔更省空間。Skills 的寫法可以參考 Claude Code Skills 入門,也可以教導 Agent 做完一件事情後,要它自己寫成 skill。
這些檔案都分成兩個層級。專案層級放在專案資料夾裡,只對這個專案有效,可以跟著 Git 與團隊共用,適合寫建置指令、程式風格與架構決定;使用者層級放在家目錄,對自己所有的專案都有效,適合寫個人習慣與偏好。
這些檔案該寫什麼、各工具從哪裡讀取、怎麼分層,以及彼此的優先順序,之後會另外寫一篇詳細介紹。
模型的世代與等級怎麼看
模型名稱通常由家族名、等級與版本號三個部分組成。家族名代表是哪一家公司的模型系列,等級代表同一家公司裡的大小與價位,版本號代表世代與之後的改版。三家的排列順序不同,Claude 把等級放在版本號前面,GPT 與 Gemini 放在後面。
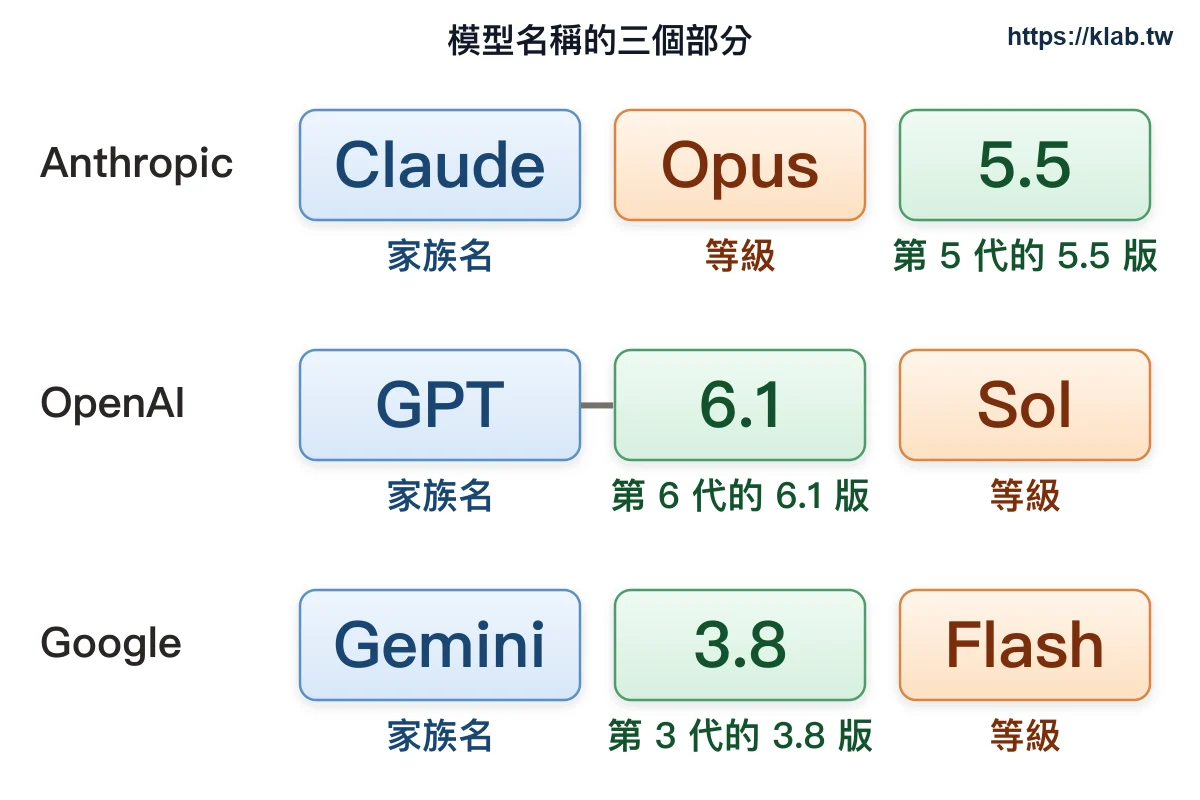
各家多半同時維持三到四個等級:等級越高,越擅長困難的推理與長時間任務,速度較慢、價格較高;等級越低,越快也越便宜,適合大量、單純的工作。各等級不一定同時更新,所以同一家公司會出現版本號不同的現行模型。
Anthropic Claude:Fable、Opus、Sonnet、Haiku
Claude 目前有四個等級,2026 年 11 月的最新版本是 Fable 5.1、Opus 5.5、Sonnet 5.5 與 Haiku 5.5。 官方模型總覽 的定位是:Fable 用於高難度推理與長時間的 Agent 工作;Opus 用於長時間的程式開發與知識工作;Sonnet 兼顧速度與能力;Haiku 用於分類、擷取、路由這類大量且要求低延遲的工作。
官方建議多數工作先從 Opus 5.5 開始,把 effort(模型回答前花多少力氣的設定,下一章說明)調到 xhigh 或 max 仍不夠時,再換 Fable 5.1。訂閱方案方面,Free 可以用 Sonnet 與 Haiku;Pro 加上 Opus 與 Claude Code,Fable 要另外使用 usage credits;Max 與 Ultra 可以用 Fable,最多占每週額度的一半。公司歷程與各代演進可參考 Anthropic 與 Claude 模型入門指南。
OpenAI GPT:Astra、Sol、Terra、Luna
OpenAI 從 GPT-5.6 開始改用新的命名方式。 GPT-5.6 發表文 寫著,數字代表模型世代,Sol、Terra 與 Luna 是長期固定的能力層級,各層級依自己的週期更新。GPT-6 世代另外推出定位在 Sol 之上的 Astra,所以 2026 年 11 月的現行模型是 GPT-6 Astra、GPT-6.1 Sol、GPT-6.1 Terra 與 GPT-6 Luna:Sol 與 Terra 已更新到 6.1,Astra 與 Luna 仍是 6。
官方模型頁 的定位是:Astra 能力最強,用於最困難的工作;6.1 Sol 以較低成本提供接近 Astra 的表現;6.1 Terra 快速、有效率,擅長視覺推理、操作電腦與自然的寫作;Luna 最省資源,適合單純、大量的工作。在 ChatGPT 選擇 GPT-6 時,思考檔位 Instant 到 Extra High 由 GPT-6 Sol 回答,Pro 由 GPT-6 Astra 驅動;2026 年 11 月時,6.1 Sol 與 6.1 Terra 只在 ChatGPT Work 與 Codex 使用。方案方面,ChatGPT Free 使用 Luna 等級的模型,Plus 可選 Medium 與 High,Pro 可用到 Extra High 與 Pro。各模型的發表細節見 GPT-6 Astra 發表 與 GPT-6.1 Terra。
Google Gemini:Argon、Pro、Flash、Flash-Lite
Gemini App 的模型選單 由低到高是 Flash-Lite、Flash、Pro 與 Argon。API 上各等級的最新版本號各不相同:Gemini 3.5 Flash-Lite、Gemini 3.8 Flash、Gemini 3.1 Pro Preview,以及 2026 年 10 月 13 日全面開放的 Gemini 4 Argon。截至 2026 年 11 月初,Flash 已更新到 3.8,Pro 的最新版本仍是 3.1 Preview;Google 在 2026 年 7 月表示 3.5 Pro 正與合作夥伴測試,到 11 月初官網仍標示 coming soon。
Gemini 4 Argon 是 Google 在 2026 年 10 月 13 日全面開放的前沿模型;10 月 28 日發表的 Gemini 4 Carbon 能力更強,但截至 2026 年 11 月初,只開放美國政府與部分資安防禦單位預先測試。官方沒有說明 Argon 是取代 Pro 還是新增一個等級,下方對照表依 App 選單的順序把 Argon 放在最高階。方案方面,沒有訂閱可用 Auto 或 Flash-Lite,Google AI Plus 可以用到 Pro,Google AI Pro 與 Ultra 才能用 Argon。
各家模型等級對照表
下表依官方定位與 App 選單順序,排出各模型在自家陣容裡的位置,同一列代表位置相近。
| 等級 | Anthropic | OpenAI | SpaceXSI | DeepSeek | |
|---|---|---|---|---|---|
| 最高階 | Fable 5.1 $10/$50 | GPT-6 Astra $10/$50 | Gemini 4 Argon $4/$20 | Grok 4.7 $2/$6 | V4 Pro |
| 主力 | Opus 5.5 $4/$20 | GPT-6.1 Sol $2/$10 | Gemini 3.1 Pro Preview $2/$12 | — | — |
| 快速 | Sonnet 5.5 $2/$10 | GPT-6.1 Terra $1/$5 | Gemini 3.8 Flash $1.50/$7.50 | — | V4.1 Flash |
| 輕量 | Haiku 5.5 $0.10/$0.50 | GPT-6 Luna $0.10/$0.50 | Gemini 3.5 Flash-Lite $0.30/$2.50 | — | — |
Gemini 4 Argon 到 2026 年 11 月 30 日為特價 $2/$10,Gemini 3.8 Flash 到 2026 年 12 月 31 日為特價 $0.75/$3.75。
截至 2026 年 11 月,SpaceXSI 官方只推薦 Grok 4.7 一款通用模型,沒有 Pro、Flash 這類分級;DeepSeek 官方沒有標示哪一款是旗艦,表中依名稱把 V4 Pro 放在最高階。同一列的價格也不一定相同,Opus 5.5 與 GPT-6.1 Sol 都是自家的主力模型,Opus 的單價是 Sol 的兩倍。
Effort 是什麼
Effort 是控制同一個模型回答前花多少力氣的設定:調高時,模型會想得更久、更仔細,也可能使用更多工具;調低時回答較快、用量較少,但處理困難問題的能力會下降。各家名稱不同,Anthropic 叫 effort,OpenAI 叫 reasoning effort,Google 叫 thinking level,ChatGPT 與 Gemini App 則用「思考」的檔位呈現。
模型的思考過程也是 token,三家都以輸出 token 計費,思考內容也會占用上下文視窗。 Anthropic 文件 提到,effort 影響整個回應的所有 token,包含文字、工具呼叫與思考,effort 較低時,工具呼叫的次數也比較少; 思考內容即使沒有顯示出來,也照樣以輸出計費。 Anthropic 的選模型指南 也寫,調整 effort 往往比換模型更有效。
各家的 effort 檔位與預設值
2026 年 11 月各工具的設定位置、檔位與預設值:
| 工具 | 在哪裡調 | 檔位 | 預設或官方建議起點 |
|---|---|---|---|
| Claude Code | /effort,或啟動時加 --effort | low、medium、high、xhigh、max | Opus 5.5、Sonnet 5.5、Haiku 5.5 預設 medium |
| Claude App | 送出鍵旁的模型選單 → Effort | Low、Medium、High、Extra high、Max | 選單中標示 Default 的檔位 |
| Claude API | output_config.effort | low~max | Opus 5.5、Haiku 5.5 預設 medium,Fable 5.1、Sonnet 5.5 預設 high |
| ChatGPT | 選 GPT-6 後的 Thinking 滑桿 | Instant、Medium、High、Extra High、Pro | 可用檔位依方案而定 |
| Codex | 桌面版的 Power 滑桿、CLI 的 /model、config.toml 的 model_reasoning_effort | low、medium、high、xhigh、max、ultra | 官方建議 Luna 從 high 開始,Astra 從 low(介面顯示為 Light)開始 |
| OpenAI API | reasoning.effort | none~max,依模型而定 | GPT-6.1 Sol、GPT-6.1 Terra、GPT-6 Luna 預設 medium |
| Gemini App | 選模型後的思考等級 | Low、Medium、High | Low |
| Gemini API | thinking_level | low、medium、high,部分模型另有 minimal | 4 Argon、3.8 Flash 預設 medium,3.1 Pro Preview 預設 high |
| Grok API | reasoning_effort | low、medium、high、xhigh | high,無法關閉思考 |
| DeepSeek API | reasoning_effort | low、high、max | high |
同樣叫 medium 或 high,各家的預設與實際用量各自定義。Claude Sonnet 5.5 在 Claude Code 預設 medium,在 API 預設 high; Codex 文件 也提到,不同世代模型的 effort 檔位無法直接對應,換工具或換模型時要重新確認預設值。Codex 的 Max 與 Ultra 用法不同:Max 讓同一個模型想更久,Ultra 則用多個子 agent 平行處理。
怎麼選 effort
各家官方的建議大致相同:先用預設值,品質不夠再往上調。 Claude Code 文件 建議,腦力激盪、初稿或重新命名這類小改動用 low,在既有專案裡修 bug 用 high;max 可能出現報酬遞減,也容易想太多。 OpenAI 把 medium 當成多數工作的預設,xhigh 只建議在評測顯示明顯改善時使用;Codex 文件也寫,大多數工作不需要 Max 或 Ultra。
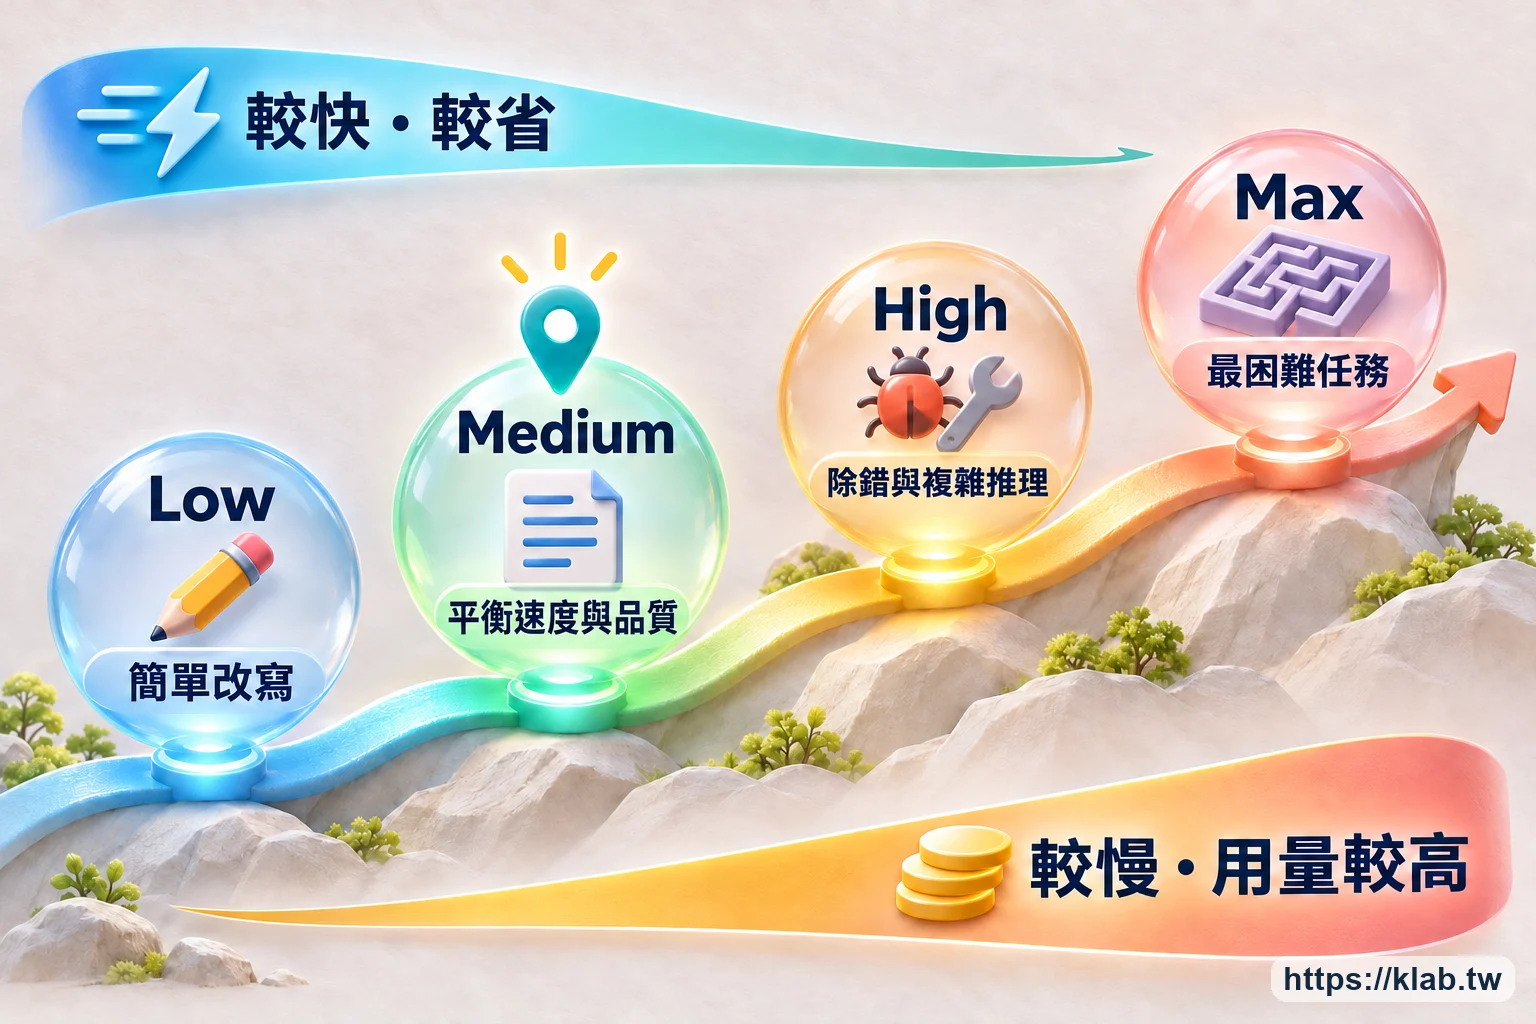
在 Claude Code 的提示詞裡寫「think hard」不會提高 effort,要調整就用 /effort;只想讓某一輪想得更深,可以在提示詞裡寫 ultrathink。訂閱使用者也要留意額度,Claude 與 Gemini 的說明都提到,effort 或思考等級越高,用量越多,越快碰到額度上限。
常見問答
上下文視窗越大的模型越好嗎?
要看工作內容。一次要讀進整份合約、整個專案時,視窗大小決定放不放得下;一般問答與寫程式很少用滿 100 萬 tokens,這時模型等級與 effort 對結果的影響更大。
開新對話後,AI 會忘記之前說過的事嗎?
會。新對話不帶舊對話的上下文,只有 Claude Code 的 CLAUDE.md、ChatGPT 的記憶這類設定,會在每個新對話自動載入。要長期遵守的偏好與規則,寫在這些地方比每次在對話裡重新交代可靠。
harness 跟 MCP 有什麼不同?
MCP(Model Context Protocol)是讓 AI 應用程式連接外部工具與資料的開放標準,Anthropic 把它比喻成 AI 應用程式的 USB-C 連接埠;harness 是使用這些工具的那一層。Claude Code、Codex 可以透過 MCP 接上資料庫、瀏覽器或公司內部系統。
用 API 和訂閱方案有什麼差別?
訂閱方案按月付固定費用,在 App、Claude Code 或 Codex 裡使用,用量受方案額度限制;API 依實際的 token 用量計費,適合把模型接進自己的程式或大量處理資料。兩者的額度與帳單分開計算。一般來說,訂閱方案比 API 用多少算多少便宜很多,個人使用建議直接選訂閱方案。
參考來源
- Anthropic: Building effective AI agents (建構有效的 AI Agent)
- Anthropic: Effective context engineering for AI agents (AI Agent 的上下文工程)
- Claude Code Docs: How Claude Code works (Claude Code 的運作方式)
- Claude Code Docs: Manage costs effectively (管理 Claude Code 的費用)
- Claude Code Docs: Model configuration (模型與 effort 設定)
- Claude Platform Docs: Context windows (上下文視窗)
- Claude Platform Docs: Effort (Effort 參數)
- Claude Platform Docs: Models overview (Claude 模型總覽)
- Claude Platform Docs: Pricing (Claude API 價格)
- OpenAI API: Models (OpenAI 模型總覽)
- OpenAI API: Reasoning models (推理模型與 reasoning effort)
- OpenAI API: Pricing (OpenAI API 價格)
- ChatGPT Learn: Models (Codex 的模型與推理設定)
- OpenAI Developers: Codex as a platform: build on the open agent harness (Codex 與 agent harness)
- Gemini API: Long context (長上下文)
- Gemini API: Gemini thinking (Gemini 的思考等級)
- Gemini API: Models (Gemini 模型總覽)
- Gemini Apps Help: About Gemini models (Gemini App 的模型與方案)
- Google: Gemini 4 Argon is now available for everyone (Gemini 4 Argon 全面開放)
- SpaceXSI Docs: Grok Models & Pricing (Grok 模型與價格)
- DeepSeek API Docs: Models & Pricing (DeepSeek 模型與價格)